


¿Pero qué está pasando?
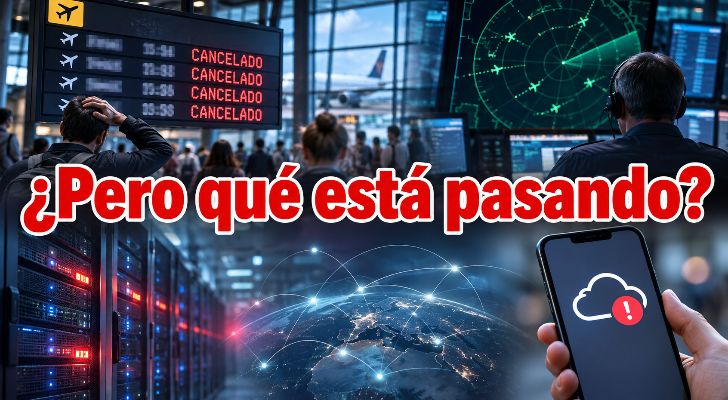
En menos de una semana, Microsoft ha dejado a millones de usuarios sin correo electrónico, Estados Unidos ha tenido que paralizar los despegues de sus aeropuertos, varios bancos han sufrido problemas con sus operaciones, una compañía aérea ha tenido que detener sus vuelos, Apple ha experimentado una caída de servicios y hasta la Agencia de Seguridad Nacional estadounidense ha reconocido una interrupción en su red. Por si fuera poco, un ciberataque ha conseguido introducir código malicioso en las páginas de algunas de las mayores empresas del mundo, entre ellas IKEA, HSBC, Zoom y la BBC. ¿Estamos ante una campaña coordinada de sabotaje digital o simplemente estamos descubriendo lo frágil que es la tecnología de la que dependemos?
Todo empezó a llamar la atención el jueves 12 de noviembre, cuando numerosos usuarios de Microsoft 365 comenzaron a experimentar problemas para acceder a sus correos electrónicos. Outlook dejó de funcionar correctamente, los mensajes se retrasaban y algunas funciones de Teams, Copilot y otros servicios también se vieron afectadas.
No estamos hablando de una pequeña incidencia. La interrupción tuvo alcance mundial y afectó a empresas, organismos públicos y administraciones de distintos países. Según los datos recogidos por Downdetector, se registraron más de 7,4 millones de notificaciones de problemas durante el incidente. Microsoft consiguió recuperar progresivamente el servicio y el sábado 14 anunció que la situación estaba completamente normalizada.
¿Un ataque informático? Según la compañía, no. La investigación apunta a problemas en su infraestructura de servidores. El informe posterior al incidente sitúa el impacto principal en Exchange Online, el servicio que gestiona el correo electrónico y parte de las funciones de calendario de Microsoft 365.
Pero cuando todavía se estaban recuperando los servicios de Microsoft, ocurrió algo bastante más espectacular. El viernes 13 de noviembre, alrededor de las diez de la noche en España, la Administración Federal de Aviación estadounidense (FAA) ordenó detener los despegues en todo el país. Prácticamente de golpe. Los aviones que ya estaban en el aire continuaron bajo supervisión de los controladores, pero las salidas quedaron paralizadas durante más de cuatro horas. El resultado fue un caos de retrasos, cancelaciones y pasajeros atrapados en los aeropuertos que se prolongó durante el fin de semana. La propia FAA contabilizó unas 12.462 cancelaciones el viernes, aunque aclaró expresamente que no todas fueron consecuencia directa de la interrupción.
¿Qué pudo provocar semejante desastre? Un router. Sí, uno de esos dispositivos cuya función consiste en encaminar las comunicaciones entre distintos sistemas, aunque bastante más sofisticado que el que tenemos en casa.
Durante una operación rutinaria de sustitución de equipos de telecomunicaciones en una instalación de Arkansas, un dispositivo comenzó a generar un volumen anormal de tráfico. Según la FAA, la red llegó a recibir aproximadamente mil intentos de conexión cada cuatro o cinco segundos. Aquella avalancha de comunicaciones desestabilizó equipos antiguos de la infraestructura aeronáutica y afectó a los sistemas utilizados por los controladores, incluidas las comunicaciones y la información radar. Ante la posibilidad de que los controladores no dispusieran de información suficientemente fiable, las autoridades tomaron la decisión de detener los despegues.
La FAA ha identificado el origen de la perturbación y desactivado preventivamente la misma funcionalidad en más de sesenta routers similares. Lo que todavía debe aclararse completamente es si el fallo inicial se debió a un defecto del equipo o a un error durante su instalación.
El sábado continuaron los problemas y el domingo 15 se produjo otra incidencia, esta vez en Amazon Web Services. Varios servicios de la región estadounidense US-East-1 experimentaron dificultades de autenticación y conectividad durante unas horas.
Y llegó el lunes. El 16 de noviembre, miles de clientes de JPMorgan Chase comenzaron a comunicar problemas con sus cuentas y operaciones bancarias. Las dificultades también repercutieron en transferencias y servicios relacionados con otras entidades, incluido Zelle. La explicación ofrecida por el banco fue un fallo de software en sistemas propios. Chase aseguró que no había indicios de un ciberataque.
Ese mismo lunes, United Airlines sufrió otro problema tecnológico que obligó a detener temporalmente numerosas salidas durante aproximadamente hora y media.
Y al día siguiente le tocó a Apple. El martes 17, la compañía reconoció interrupciones en servicios como App Store, Apple Music, AppleCare y el acceso a cuentas de iCloud. También aparecieron numerosas quejas relacionadas con Apple Pay. La explicación de Apple fue que una actualización interna había provocado problemas que estaban tratando de corregir.
Como guinda del pastel, ese martes la mismísima Agencia de Seguridad Nacional estadounidense, la NSA, reconoció una degradación temporal de su red interna durante trabajos de mantenimiento. Según la agencia, las capacidades críticas para sus operaciones permanecieron disponibles.
Hasta aquí tenemos una sucesión de fallos tecnológicos extraordinariamente llamativa. Pero falta un episodio que sí pertenece a una categoría diferente: un auténtico ciberataque. El 16 de noviembre, el investigador de seguridad Scott Helme descubrió que páginas de algunas de las empresas más conocidas del mundo estaban distribuyendo JavaScript malicioso a sus visitantes. Entre las organizaciones identificadas figuraban IKEA, Zoom, HSBC, CNN, BBC, Salesforce, Equifax y otras muchas. En total, la investigación localizó código malicioso asociado a 178 organizaciones.
Lo interesante es que los atacantes no habían necesitado entrar individualmente en los servidores de todas esas empresas. Habían aprovechado una vulnerabilidad en Optimizely, una plataforma que permite a los propietarios de páginas web experimentar con diferentes diseños y funcionalidades. Muchas empresas incorporan en sus webs pequeños fragmentos de código proporcionados por servicios externos. Cuando el visitante abre la página, su navegador ejecuta ese código como parte del funcionamiento normal del sitio.
El problema aparece cuando alguien consigue modificarlo. Eso fue precisamente lo que ocurrió. Según el informe de seguridad publicado por Optimizely el 17 de noviembre, los atacantes aprovecharon una vulnerabilidad en el proceso de registro de cuentas que les permitió suplantar a usuarios con privilegios de administrador e insertar código malicioso en proyectos de clientes. No necesitaron robar las contraseñas de esos administradores. Optimizely sitúa la primera inserción de código malicioso el 16 de noviembre a las 07:51 UTC. Detectó la actividad a las 13:34, cerró la vulnerabilidad a las 16:10 y terminó de eliminar el código de los proyectos afectados a las 22:24.
¿Qué pretendían conseguir? El programa estaba diseñado para interceptar información de tarjetas bancarias y sustituir direcciones de monederos de criptomonedas por otras controladas por los delincuentes. Los investigadores externos también encontraron funciones para obtener cookies y capturas de pantalla, así como componentes capaces de intentar explotar vulnerabilidades de determinados dispositivos iPhone.
Conviene hacer aquí una distinción importante. La presencia de un código preparado para robar información no demuestra que consiguiera hacerlo en todos los dispositivos que lo recibieron. Tampoco hay pruebas de que todas las páginas afectadas dejaran de funcionar. De hecho, el incidente de Optimizely fue principalmente un problema de seguridad, no una caída generalizada de las webs.
El análisis de Scott Helme documenta movimientos de criptomonedas hacia monederos controlados por los atacantes. Sin embargo, todavía no conocemos el número real de tarjetas comprometidas ni cuántos dispositivos pudieron resultar infectados. Optimizely, por su parte, sostiene en su informe inicial que el código investigado tenía como finalidad obtener información de pagos y operaciones con criptomonedas. La investigación forense sigue abierta, por lo que sería precipitado dar por definitivamente establecido todo el alcance del ataque. Tampoco se ha identificado públicamente a sus responsables.
Y llegamos a la pregunta inevitable: ¿tiene todo esto algo que ver?
Hasta el momento, no se ha encontrado ninguna prueba que permita relacionar los fallos de Microsoft, la FAA, JPMorgan, United Airlines, Apple o la NSA con el ataque a Optimizely. De hecho, el 17 de noviembre, el secretario de Seguridad Nacional de Estados Unidos, Markwayne Mullin, afirmó que los problemas recientes no parecían obedecer a ciberataques. Su explicación apuntaba a la dificultad de incorporar tecnologías modernas a infraestructuras informáticas antiguas.
Esto no significa que todos los incidentes tengan esa misma causa. Cada uno está siendo investigado por separado y algunos ya cuentan con explicaciones técnicas bastante concretas.
Pero sí existe un problema común que merece la pena analizar. Durante décadas hemos construido sistemas cada vez más sofisticados sobre otros sistemas que, en ocasiones, tienen muchos años a sus espaldas. Un banco depende de redes de comunicaciones, aplicaciones, servidores y proveedores externos. Una compañía aérea necesita que funcionen simultáneamente sus sistemas internos y los de control del tráfico. Y una web aparentemente independiente puede ejecutar código procedente de media docena de empresas distintas.
Cada una de esas dependencias introduce nuevas posibilidades de fallo. Además, la enorme concentración del mercado tecnológico hace que una avería en un proveedor importante pueda afectar a millones de personas que ni siquiera saben que utilizan sus servicios. Es lo que en ingeniería se conoce como un punto único de fallo: un componente cuya avería puede inutilizar una parte considerable del sistema.
Y eso explica por qué una actualización de software, una configuración incorrecta o un router defectuoso pueden tener consecuencias completamente desproporcionadas. ¿Estamos asistiendo a una ofensiva secreta contra las infraestructuras occidentales? No hay pruebas de ello. Si la hubiese, ¿nos enteraríamos? Posiblemente, tampoco. Hoy en día reconocer que has sido víctima de un ciberataque afecta más al prestigio de la compañía que a su balance económico.
Pero con la información disponible hoy, la explicación mejor respaldada es bastante menos cinematográfica.
Hemos construido una sociedad en la que sistemas de enorme complejidad dependen de componentes que pueden fallar, de proveedores que pueden ser comprometidos y de infraestructuras antiguas que no siempre responden bien a los cambios. Y quizá eso debería preocuparnos bastante más que la posibilidad de unos hackers misteriosos pulsando simultáneamente un botón rojo. Porque para paralizar medio país no siempre hace falta un sofisticado ataque informático. A veces basta con cambiar un router.


Eroton
18/11/26 14:24
«Hoy en día reconocer que has sido víctima de un ciberataque afecta más al prestigio de la compañía que a su balance económico.»
Con todo respeto, ese texto hay que cogerlo con papel de fumar, porque va a depender y mucho el tipo de compañía, y el tipo y alcance del ataque.
«Porque para paralizar medio país no siempre hace falta un sofisticado ataque informático. A veces basta con cambiar un router.»
Igual lo que se pretendía decir era que «a veces basta con no haber cambiado un router.»
Gracias por el artículo, me voy, que me están empezando a pitar los oídos.